 manologarcia.dev
Gemini 4 Hydrogen y Orchestrator en Antigravity: Google apuesta por agentes que cambian de modelo solos
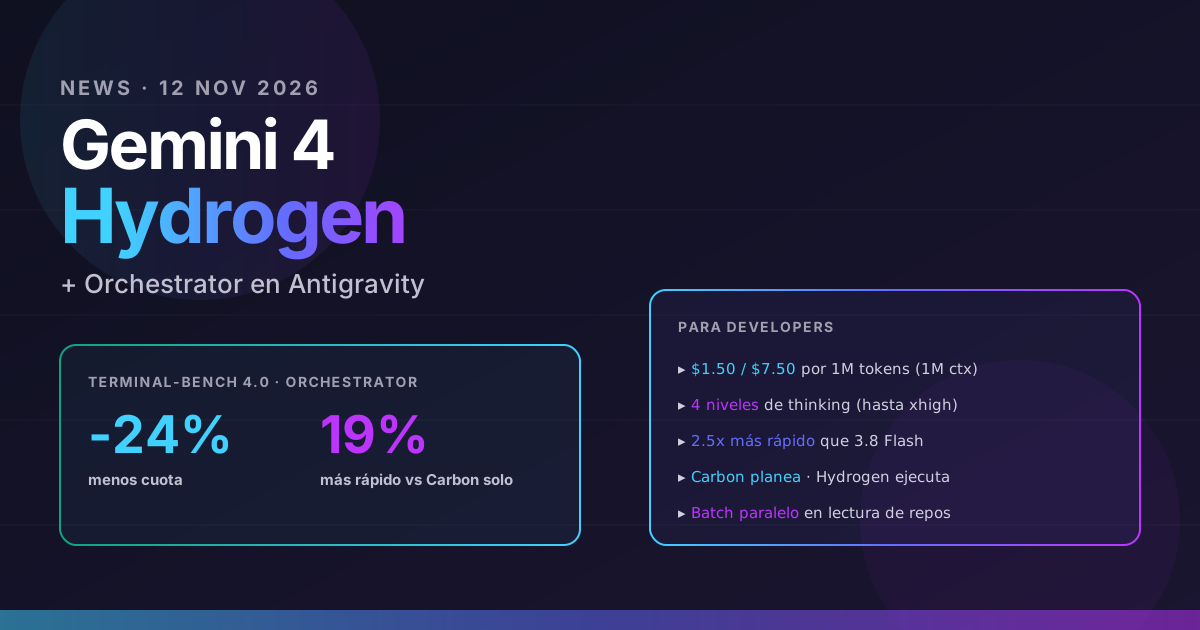
TL;DR: Google presentó Gemini 4 Hydrogen el 12 de noviembre de 2026 ($1.50/$7.50 por millón de tokens, 1M de contexto) junto a Orchestrator en Google Antigravity: Carbon planea en solo lectura e Hydrogen ejecuta código y pruebas, ahorrando 24% de cuota y 19% de tiempo en Terminal-Bench 4.0.
Qué anunció Google para desarrolladores
Dos días después de habilitar al público general Gemini 4 Carbon (10 de noviembre) y lanzar /swarm para equipos de agentes en paralelo, Google presentó el 12 de noviembre Gemini 4 Hydrogen, su guía para developers y Orchestrator en Antigravity.
La premisa es práctica: no todas las subtareas de una sesión justifican la latencia y costo de un modelo frontera. Mientras Carbon cubre razonamiento de largo horizonte, Hydrogen apunta a ejecución diaria en Google AI Studio, Gemini API, Android Studio y Antigravity:
- Contexto y precio plano: ventana de contexto de 1 millón de tokens con precio plano: $1.50 por millón de entrada y $7.50 por millón de salida.
- Cuatro niveles de pensamiento:
low,medium,high(por defecto) yxhigh. - Velocidad y precisión frente a 3.8 Flash: en
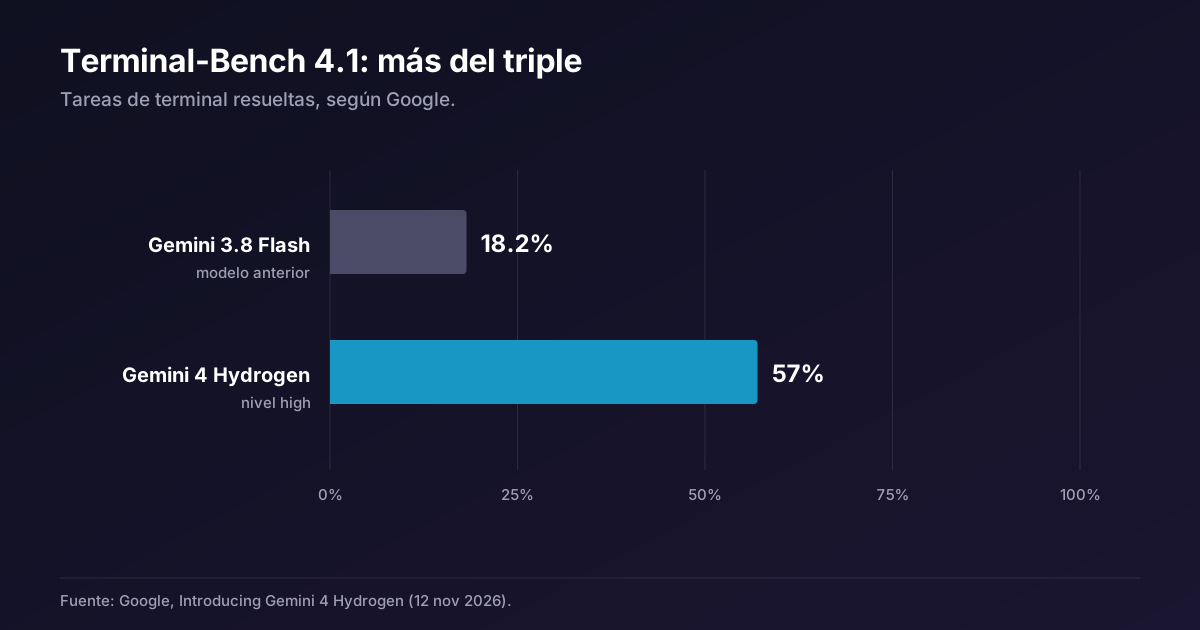
highsupera a Gemini 4 Argon en el Artificial Analysis Intelligence Index (51 vs. 50; 54 enxhigh). Termina tareas 2.5x más rápido que 3.8 Flash, más que triplica su resultado en Terminal-Bench 4.1 (de 18.2% a 57%) y reduce afirmaciones inventadas más de 5x. - Lectura paralela de repositorios: agrupa en paralelo lecturas de archivos y búsquedas en vez de abrir uno por uno; en pruebas con socios (grafos, SQL y datos) corrió entre 2x y 2.8x más rápido con 12% a 23% menos tokens.
- Seguridad agéntica: recorta el exceso de alcance (overreach) hasta en 81%, baja 12x atajos o acciones desalineadas y mejora más de 2.3x la resiliencia contra indirect prompt injection en Gray Swan IPI.
Cómo funciona Orchestrator en Antigravity
Lo más útil para el flujo diario es Orchestrator, disponible en el selector de Antigravity (con Carbon en Google AI Ultra, y con Argon en Pro y Ultra, según InfoWorld).
En lugar de usar un router estático que adivina la complejidad desde el primer prompt, Orchestrator hace un ida y vuelta dinámico en la misma respuesta:
- Planeación en solo lectura: Carbon (o Argon) explora el repo, mapea dependencias y arma el plan con disparadores explícitos de re-planeación.
- Ejecución rápida: pasa el control a Hydrogen para editar archivos, instalar paquetes y correr pruebas.
- Rescate automático: si Hydrogen falla repetidamente en tests o choca con errores inesperados, devuelve el turno al planificador para corregir el rumbo y retomar.
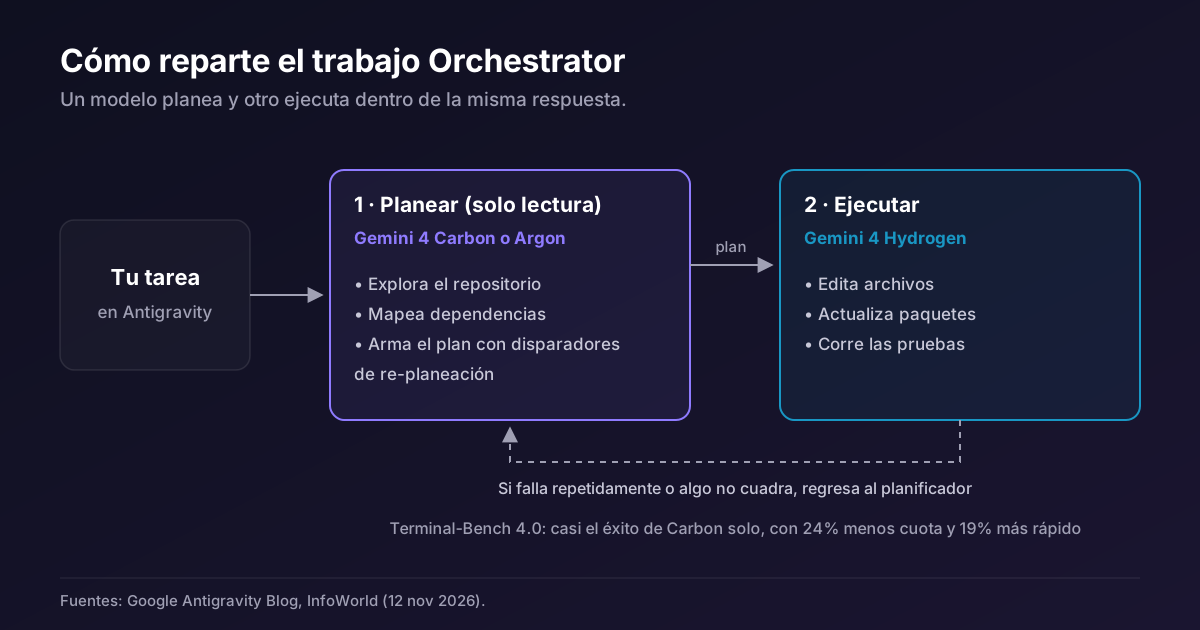
En Terminal-Bench 4.0, este esquema casi igualó la tasa de éxito de Carbon solo, consumiendo en promedio 24% menos cuota y terminando 19% más rápido.
El pendiente de auditoría y la respuesta de OpenAI
En InfoWorld, el analista Pareekh Jain advierte un hueco para empresas: los CIOs necesitan saber qué modelo tomó cada decisión o hizo cada cambio, y sin logs por modelo ni atribución clara será difícil auditar el código generado. Mientras eso llega, toca mantener permisos restringidos y revisión humana en los PRs.
En paralelo, hoy 17 de noviembre OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol en GitHub Copilot y API, bajando Astra 20% ($8/$40 por millón; Sol sigue en $2/$10). En el análisis independiente de Artificial Analysis, Astra alcanzó el #2 global en inteligencia general pero quedó plano en el Coding Agent Index frente a GPT-6, y Sol cayó 3 puntos respecto a 6.1 Sol.
Mi opinión como dev
Como conté cuando Antigravity lanzó extensiones para otros editores, muchos ya cambiábamos manualmente de un modelo razonador a uno rápido en medio de una sesión. Automatizar ese relevo entre "arquitecto en solo lectura" y "ejecutor veloz" dentro del mismo turno es el camino correcto. Solo falta tener trazabilidad por paso en el log para saber exactamente quién tocó qué.
Fuentes
- Google Blog: Introducing Gemini 4 Hydrogen for Agentic Workflows (12 nov 2026)
- Google Blog: Gemini 4 Hydrogen: Fast agentic development for coders (12 nov 2026)
- Google Antigravity Blog: Gemini 4 Hydrogen and Orchestrator
- InfoWorld: Google adds multi-model Orchestrator, Gemini 4 Hydrogen, to Antigravity
- GitHub Changelog: OpenAI's GPT-6.2 Astra and GPT-6.2 Sol now available (17 nov 2026)
- Artificial Analysis: GPT-6.2 Astra and GPT-6.2 Sol evaluation (17 nov 2026)